SquashFS против архиваторов в Linux: плюсы и минусы


13 коммент.
Задача: сравнить степень и скорость сжатия файловой системы SquashFS и распространённых архиваторов под Linux, а так же ещё раз упомянуть, где и когда можно (и нужно) использовать сжатые файловые системы.

Преамбула
Здесь я писал о том, что такое SquashFS и зачем оно надо. Иногда удобно использовать такие файловые системы вместо архиваторов, и не столько из-за степени сжатия (которая у архиваторов выше), а за большую скорость доступа и возможность работы с данными без разархивации. Например, вы скачали какой-нибудь сайт целиком wget-ом. Это куча html-ек и графических файлов, но они занимают много места, менять вы их не собираетесь, а хотите только просматривать время от времени. Легко и просто: сжимаем каталог с сайтом:
mksquashfs www.vasya.ru www.vasya.ru.sq
Расширение можно указать любое, которое понравится. Потом, когда захотите посмотреть на этот сайт и побродить по нему, просто прикручиваете на петлевое устройство файл - и вперёд. Распаковка "на лету" происходит незаметно - для современных процессоров это семечки. Посмотрели, открутили - и забыли. Удобно, просто и легко.
Вариант: есть много ISOшников, которые не так часто используются. Сжимаем их тоже в SquashFS, а когда надо, например, погонять их в эмуляторе, просто прикручиваем на петлю и указываем эмулятору на iso-файл, который виден в точке монтирования. И никакой утомительной разархивации.

Тестирование SquashFS в Linux
Проводилось тестирование на скорость и степень сжатия по шести видам файлов (которые у меня чаще всего попадаются). Красным выделялся архиватор с наибольшей степенью сжатия. Участие в тестировании приняли архиваторы, наличествующие в Debian GNU/Linux (и кое-какие, в нём по религиозным лицензионным соображениям отсутствующие, но установленные), как то: bzip2, p7zip (многопоточный), gzip, arj, rar (проприетарный, полнофункциональная trial-версия, после тестирования удалён), mksquashfs v3.0, mksquashfs v3.1 (многопоточный).
Тестирование проводилось на машине следующей конфигурации: P4 630 (3GHz, 2Mb cache, HyperThreading), Intel i915 PGNL Motherboard, 2Gb DDRAM, HDD 36Gb WD Raptor + 250Gb WD 250JB, ATi X200 VideoCard. OS Debian GNU/Linux v3.1 "Sarge" с оптимизированным ядром Linux версии 2.6.15.7 \#1 SMP PREEMPT i686. На момент тестирования время непрерывной работы машины составляло 95 дней.
При архивировании утилитам передавались параметры:
  • mksquashfs
  • rar a -m5
  • bzip2 --best -z
  • p7zip
  • gzip --best
  • arj a -m4
Запуск проводился скриптом на bash, в консоли, графический сервер был выключен. Никаких ресурсоёмких процессов на фоне запущено не было.

1. Много больших несжатых полутоновых видеофайлов
Тест несколько искусственный, так как эти "фильмы" сделаны из простых полутоновых BMP-файлов. В свободном виде они занимают просто чудовищный объём, а нужны для оптических экспериментов (эксперимент MotionScreen, кому надо, тот знает). В чистом виде занимают 1.5Гб, а вот что с ними стало после архивирования:


Архиватор Время Компрессия


squashfs 3.0 61 175,07


squashfs 3.1 83 175,07


rar 114 508,66


bzip2 140 2900,95


p7zip 307 5017,85


gzip 101 191,5


arj 31 53,24


Архиватор p7zip показал самую высокую степень сжатия, однако, несмотря на то, что он работал в многопоточном режиме (ядро с активированной поддержкой HyperThreading), сжимал дольше всех. Хвалёный и тем более несвободный rar порядком проигрывает свободному bzip2 при сравнимой скорости сжатия. Сжатие squashfs несколько в стороне, хотя и довольно быстрое. Занятно, что многопоточное исполнение для утилиты сжатия squashfs даже снизило её быстродействие (тест запускался трижды, значения те же).

2. Цветные RAW-файлы
Фотографии в формате "прямо с камеры" объёмом в 90 Мб были сжаты теми же архиваторами - посмотрим, что из этого вышло:


Архиватор
Время
Компрессия


squashfs 3.0
14
1,06


squashfs 3.1
13
1,06


rar
61
1,1


bzip2
37
1,14


p7zip
72
1,12


gzip
12
1,06


arj
1
1


Здесь с незначительным перевесом по степени сжатия, но почти вдвое по скорости обскакав конкурентов, лидирует bzip2. В этой программе squashfs выглядит уже не так бледно, находясь так же на уровне gzip.

3. Офисные документы
Здесь я вытащил find-ом всё, что имело расширение doc, odt, xls и ods. Получилось немного, на 30Мб, но тем не менее:

Архиватор
Время Компрессия


squashfs 3.0
4 1,07


squashfs 3.1
4 1,07


rar
20 1,07


bzip2
15 1,07


p7zip
19 1,13


gzip
4 1,07


arj
0 1,05


Здесь свободный p7zip снова делает проприетарный rar, причём не только по степени сжатия, но и по скорости (а вот тут, быть может, HyperThreading и сыграл, а rar его не держит - проприетарщина, а ещё денег просит). SquashFS очень шустрый, и компрессия неплохая, очень похожая по результатам на gzip (в этом тесте размер архива gzip и sq просто совпали байт-в-байт, что наводит на мысль о том, что в squashFS сжатие если не zip, то во всяком случае очень похожее).

4. Полутоновые графические файлы TIF
Много экспериментальных результатов приходится хранить в tif-файлах, так что интерес к тому, кто круче их жмёт (не обязательно быстро) неслучаен. Сжато файлов на 82Мб, вот результаты:


Архиватор
Время
Компрессия


squashfs 3.0
20
1,81


squashfs 3.1
18
1,81


rar
48
1,97


bzip2
25
2,4


p7zip
132
2,23


gzip
19
1,86


arj
6
1,51


Первое место вновь за свободной программой: bzip2 очень лихо жмёт tif-файлы, а кроме того очень быстро. Чуть меньше степень сжатия у p7zip. SquashFS при той же компрессии в многопоточном режиме жмёт немного быстрее, но тоже на уровне gzip - как по скорости, так и по сжатию (здесь разница между ними была ровно 200 байт).

5. Скачанный сайт
Мой любимый тест - сайтов я качаю много, так что очень и очень актуально. Здесь пожат портал www.teatips.ru, где находится всё, что можно и нужно узнать о чае. Всего 460Мб, немного терпения и результат:


Архиватор
Время
Компрессия


squashfs 3.0
38
3,49


squashfs 3.1
30
3,49


rar
167
3,03


bzip2
257
4,41


p7zip
188
4,59


gzip
22
4,26


arj
19
2,68


Картина маслом: rar сливает squashfs по всем статьям! Очень радостно видеть первые три места за свободными программами. Впрочем, результат по времени p7zip можно оспорить: здесь скорее всего заиграл снова гипертреадинг, что видно и по squashFS (та же степень сжатия, но быстрее на 21%, что неплохо коррелирует с заверениями Интел про прибавку до 30% производительности на некоторых задачах). Это подтверждается и визуально: многопоточные архиваторы на глаз быстрее при включённом гипертреадинге при пожатии множества мелких файлов.

6. ISO-образ
Пожат первый iso-образ диска с Дебианом Сарж, 650Мб:


Архиватор
Время
Компрессия


squashfs 3.0
74
1,03


squashfs 3.1
75
1,03


rar
718
1,05


bzip2
297
1,03


p7zip
411
1,05


gzip
65
1,03


arj
16
1


Rar таки обошёл p7zip, но на сколько? Не поверите, но аж на 0,0039% - я уверен, что это стоит тех денег, которые Рошаль с вас потребует за консольную версию своего чудотворного архиватора.
В общем, сжимать iso-шники здорово простым gzip, быстро и примерно так же по компрессии, как и все другие. А ещё лучше isoшники пожимать в squashFS, ибо их можно пропаливать на болванки и гонять в эмуляторах, даже не распаковывая.

Итоги
Ну вот, пока тесты закончились и заметка написана, и в комнате теплее стало. :-)
Здесь хотелось бы отметить важный момент: открытые архиваторы почти всегда уделывают проприетарные, либо по скорости, либо по компрессии. Так что для того, чтобы эффективно сжимать свои данные, вовсе не обязательно платить за это деньги, так как p7zip и bzip2 есть под распространённые платформы и распространяются под GPL-совместимыми лицензиями.
SquashFS по компрессии и скорости близка к gzip, что вовсе не так плохо: в ряде случаев её применение более чем оправдано, особенно если вы часто имеете дело со скачанными сайтами или большим количеством редко изменяемых офисных документов.
Читать далее

Запись CD и DVD дисков в Linux: Как записать CD/DVD диск под Linux


28 коммент.
Задача: нужно записывать CD и DVD диски с данными в Linux без графических утилит. Чем прожигать диски в Linux?

Решение: все программы записи дисков под Linux есть просто графические оболочки к базовым утилитам cdrecord/wodim и growisofs. В некоторых случаях эти оболочки вносят свои дополнительные проблемы в процесс записи дисков, так что я их никогда не использовал. Чтобы не забыть самому и если кому интересно - ниже описание процесса.
В этом посте приводятся только основные команды и параметры утилит, которыми я пользуюсь постоянно - пост ни в коем случае не отменяет чтение man mkisofs cdrecord growisofs и других.

Как узнать адрес привода
Запись на привод проводится через ATAPI, а не эмуляцию SCSI, как когда-то делали. Для этого пишем в консольке:
sudo cdrecord -scanbus dev=ATAPI
Выдаст он нам что-то вроде:

Cdrecord-Clone 2.01.01a01 (i686-pc-linux-gnu) Copyright (C) 1995-2004 Joerg Schilling
'@(#)scsitransp.c 1.91 04/06/17 Copyright 1988,1995,2000-2004 J. Schilling').

scsibus0:
0,0,0 0) '_NEC ' 'DVD_RW ND-3550A ' '1.05' Removable CD-ROM

0,1,0 1) *

0,2,0 2) *

0,3,0 3) *

0,4,0 4) *

0,5,0 5) *

0,6,0 6) *

0,7,0 7) *

Выделенная полужирным строка - это и есть наш привод, а цифры 0,0,0 - его адрес, который и подставляем в качестве цели для записи диска через ATAPI. Но об этом ниже.

Запись CD-R/RW дисков
Для этого нужно установить либо сторонние пакеты cdrtools, либо пакты из Etch, которые называются cdrkit (свободная версия cdrtools). Тогда в вашем распоряжении окажутся утилиты cdrecord для записи/очистки дисков, mkisofs для создания ISO-образов из файлов, cdda2wav для сдирания с образа аудиотреков. Всё это нам понадобится для создания и пропаливания дисков.

Создание ISO-образа
Если нужно создать сперва ISO-образ для пропаливания, пользуемся утилитой mkisofs. Тут есть некоторые тонкости, например, под Windows XP и другими версиями Windows не воспринимаются права файлов, что принято в *nix-системах. Так же, если требуется пропалить диск для юниксоида с правами доступа, то нужно использовать опцию -r, которая включает расширение RockRidge стандартной iso9660. Если нужны длинные имена файлов и русские их названия, то включаем расширение Joliet. Короче говоря, чтобы из каталога /home/vasya/stuff сделать iso-образ под названием disk.iso, пишем в консольке следующее:
mkisofs -joliet-long -r -o disk.iso /home/vasya/stuff
После этого в каталоге, из которого вызывалась программа, появится disk.iso, который теперь можно пропаливать на болванку.

Запись CD-R дисков
Если уже есть ISO-образ и его надо просто пропалить, то надо вызвать cdrecord и указать ему скорость пропаливания, адрес устройства и непосредственно сам образ. Делается это так:
cdrecord -v speed=40 dev=ATAPI:0,0,0 my.iso
То есть записать с подробным выводом сообщений на скорости 40 на устройство ATAPI:0,0,0, (Primary Master 1-ого IDE-канала) образ my.iso - всё логично и понятно. Пока пропаливается диск - сворачиваем окошко консоли и занимаемся другими делами.

Можно поступить и так: чтобы не задавать руками скорость и завернуть команду в полностью автоматический скрипт, укажите speed=0, тогда программа сама выберет подходящую скорость, на которой болванка будет гарантированно читаться и привод её не запортит. Чтобы вообще не вспоминать потом про параметры, можно их прописать в /etc/cdrecord/cdrecord, в котором можно "определить" устройство, на которое будет производиться запись - то есть, прописать его ATAPI адрес, размер буфера FIFO, назначить имя этому устройству, и в дальнейшем обращаться к этому устройству по имени, при записи.

Всё это очень легко заворачивается в башевские/перловые (по вкусу) скрипты и выполняется через некоторое время на полном автомате, что однозначно быстрее всяких приблуд типа k3b с их GUIёвым интерфейсом.

Запись CD-RW дисков в Linux
Здесь немного поинтереснее, так как если на диске что-то есть, то вариантов становится больше: дописать информацию или снести оттуда всё и записать снова. Для того, чтобы очистить болванку, есть несколько методов, реализованных в cdrecord: быстрая очистка, только указанная сессия, полная очистка и другие. Например, для быстрой очистки пишем:
cdrecord -v blank=fast dev=ATAPI:0,0,0
и через пару секунд на него уже можно писать новые данные.
Запись CD-RW дисков ничем не отличается от записи обычных однократных болванок, и команда:
cdrecord -v speed=40 dev=ATAPI:0,0,0 my.iso
пропаливает диск точно так же. Только следите за указанием скорости пропаливания - для перезаписываемых болванок она ниже, чем для однократных.

Кстати, о скоростях. Утилита cdrecord поступает очень грамотно, на мой взгляд, что начинает запись с маленькой скорости, и постепенно подбирается к указанной максимальной, если это возможно. А не как некоторые безмозглые проприетарные громилы, которые сразу пытаются писать на большой скорости, а если не удаётся - скидывают скорость вдвое и на ней пишут весь диск. Скорость записи болванки может варьироваться в зависимости от производителя и нагруженности системы в данный момент. Для CD болванок 1х = 150 Кб/сек, при записи Audio-CD 1х = 172 Кб/сек, для DVD 1х = 1385 Кб/сек.

Запись DVD-R/RW дисков
Для этого нужно поставить утилиты dvd+rw-tools, которые входят в дистрибутив и включают в себя программы для записи и форматирования DVD-дисков. После этого, помимо других утилит, в нашем распоряжении будет growisofs для создания и записи образов на DVD, а так же dvd+rw-format для предварительного форматирования перезаписываемых DVD+RW. Запись DVD немного отличается от записи простых CD-болванок, так что ниже приведу команды для этого.

Запись DVD-/+R дисков в Linux

Для этого нам потребуется утилита growisofs, которая входит к комплект dvd+rw-tools, и объединяющая в себе mkisofs и cdrecord в одном флаконе. Для того, чтобы пропалить на DVD-болванку (без разницы - это DVD+R или DVD-R) файлы из каталога /home/vasya/something, пишем в консольке:
growisofs -Z /dev/cdrom -R -J /home/vasya/something
где после -Z идёт устройство, которое является резаком. Даже если оно называет /dev/cdrom, не надо удивляться: утилите всё равно. Скорость утилита подберёт сама, ту, на которой болванка гарантированно пропалится без ошибок, так что форсировать процесс не стоит.

Если уж так хочется прожечь болванку побыстрее, можно рекомендовать growispfs скорость ключом -speed=N так:
growisofs -speed=8 -Z /dev/cdrom -R -J /home/vasya/something
Помним, что для DVD скорость 1х = 1385 Кб/сек.
Если нужно пропалить уже готовый ISO-образ, команда изменится так:
growisofs -Z /dev/cdrom=image.iso
В процессе записи будет постоянно выводиться информация о текущей скорости записи, прогрессе и оставшемся до конца пропаливания времени.


Запись DVD-/+RW дисков
Для начала болванку нужно отформатировать, это делается так:
dvd+rw-format -f /dev/cdrom
Если у вас другое устройство для записи, отличное от /dev/cdrom, замените его на своё. После этого запись на диск идёт так же, как и для обычных DVD-болванок:
growisofs -Z /dev/cdrom=image.iso
После этого начнётся запись, а мы можем заняться чем-то более полезным, чем созерцание процентов записываемого образа.

Возможность использования DVD-/+RW как дискеты
Есть возможность использования пакетной записи и файловой системы udf (должна быть скомпилирована поддержка ядре), чтобы работать с перезаписываемым DVD-диском как с большой дискетой. Как мне любезно написал в комментариях ув.тов. Anonymous, выглядит это так:
dvd+rw-format -f /dev/cdrom
mkudffs /dev/cdrom

После чего работаем как с простым RW сменным носителем типа дискетки или флешки:
mount -t udf /dev/cdrom /mnt/cdrom
cp /etc/* /mnt/cdrom/
rm /mnt/cdrom/shadow
eject
Просто и удобно.

Как проверить правильность записи на диск - проверка дисков в Linux
Для того, чтобы убедиться в правильности записи данных на диск, есть замечательная утилита dd, которая входит в любой дистрибутив Linux. О том, как проверить диск после записи, есть подробные инструкции на этом же блоге.


Ссылки
Помимо мануалов к утилитам, которые написаны очень толково, можно почитать о записи на разных ресурсах, перечисленных ниже.
CD:
Замечательная статья по записи через ATAPI здесь. На английском хорошая есть статья, в которой почти обо всём и толково. Теоретический, но уже немного устаревший, обзор тут, а здесь совсем зубодробильный обзор возможностей CD-приводов.
DVD:
Очень хорошая и информативная статья по записи болванок DVD здесь. На английском, но довольно просто и толково про это же есть тут. Много интересного можно почерпнуть отсюда.
Читать далее

Библиография в LaTeX, BiBTeX и JabRef


41 коммент.
Этот пост является частью большой статьи
"Как оформить диплом в LaTeX?",
которую написал virens,
ведущий блога "Записки дебианщика"

Проблема: библиографический список документов LaTeX разросся и перевалил за несколько десятков источников литературы. Требуется быстро и просто оперировать с библиографическими ссылками в научных документах.
Решение: есть кроссплатформенные системы ведения баз данных библиографических ссылок в LaTeX, одна из них - JabRef.

При написании объёмных научных трудов часто возникает проблема работы с библиографией в LaTeX. Обычно на начальном уровне освоения LaTeXники применяют для указания ссылок на литературу такую конструкцию, помещая её в конец своего tex-файла:

\addcontentsline{toc}{chapter}{Литература}
\begin{thebibliography}{99}

\bibitem{catheydowskinewparadigm} W.T. Cathey and E.R. Dowski, ``New paradigm for imaging systems'', Appl. Opt. 41, pp. 6080-6092, 2002.
Это значит буквально то, что написано: добавить главу "Литература" в конец списка, а ссылки (bibitem) указать в порядке перечисления их ниже. Вот тут-то и лежат грабли для начинающих TeXников - в тексте ссылки пронумеруются в том порядке, в котором они тут указаны, а не в порядке упоминания.

Кроме того, начнутся большие проблемы, когда вы захотите часть литературных источников включить в другой документ. Какие из них брать? В каком порядке? Или вспомнить, каким словом вы обозвали какую-то книгу или монографию? Вот тут нам и приходит на выручку BiBTeX...

Библиографические базы данных
Это простой текстовый файл, в котором перечислены ваши библиографические ссылки, и работают с этими файлами специальные (но простые для использования) программы. При этом каждый раз, когда вы собираете LaTeX-файл, создаётся специальный файл имяфайла.bib, в который из этой самой базы (bib-файла) надёргиваются источники литературы, указанные в тексте.

Таким образом, вы избавлены от забот с библиографией - теперь вы будете добавлять источники литературы не в сам LaTeX-документ, а в bib-файл при помощи удобной графической программы. Эту библиографическую базу вы сможете использовать для многих документов, что имеет свои преимущества:
  1. если в описание ссылки на литературу вкралась ошибка, её можно исправить в базе - и это будет изменено во всех документах, ссылающихся на неё;
  2. ссылки появляются по мере упоминания и нумеруются правильно;
  3. простой поиск в базе для выяснения ключа цитирования (подставляемый в \cite{});
  4. возможность использования одной базы во многих документах;
  5. импорт и экспорт в другие библиографические форматы.
Так что всё это стоит некоторых усилий - вы сможете просто писать \cite{источник} и не думать, в каком порядке и как отображается ссылка - лишь бы она была в базе. Всё просто и легко.


Как это работает
Для того, чтобы начать работу с BiBTeX, надо установить какую-нибудь оболочку к нему, создать новую библиографическую базу, заполнить её теми ссылками, которые у вас уже имеются в созданных LaTeXовских документах и слегка подправить в конце упоминание о библиографии. Если раньше вы писали в конце документа:
\addcontentsline{toc}{chapter}{Литература}
\begin{thebibliography}{99}
то теперь следует писать (не указывая расширения bib):
\bibliography{путь/к/файлу/библиографии}
например,
\bibliography{biblio/my}
и кроме того указать, какой стиль библиографических ссылок вы хотите использовать - чаще всего используется не сортированный (т.е. в порядке упоминания в тексте):
\bibliographystyle{unsrt}
Эту строчку ставим в шапке LaTeXовского документа, после разного рода \usepackage но до \begin{document}. Вот и все дела.

Здесь следует использовать возможности операционной системы, которые здорово облегчают жизнь. Например, у вас есть два LaTeX-файла в разных каталогах (скажем, две статьи). При этом они используют одну и ту же библиографическую базу, которая находится в другом каталоге - как её использовать в разных документах!? Очень просто: Linux и *BSD системы давно умеют создавать символические ссылки на файлы и каталоги. Предположим, что библиографическая база my.bib находится в каталоге ~/docs/matlab/docus/topics/biblio/ и в латеховском документе указывается как \bibliography{biblio/my} - поэтому нужно просто сделать символическую ссылку (симлинк) на каталог, в котором база хранится:
ln -s ~/docs/matlab/docus/topics/biblio/ biblio
и перекопировать симлинк в нужные каталоги, в которых находятся ваши латеховские документы. Всё, теперь все они будут работать с одной и той же базой. Легко и просто.

Надеюсь, я вас убедил и теперь осталось только всё это установить.


Приступаем к установке
Для того, чтобы всеми этими чудесами воспользоваться, нужно поставить программу-оболочку для работы с BibTeXом. Можно и руками набивать базу - пожалуйста, можно воспользоваться программами, уже имеющимися в дистрибутиве. Например, для Debian v3.1 Sarge, если поискать в репозитории:
# apt-cache search bibtex | grep tool bibtool - A tool for manipulating BibTeX data bases. bibview - X11 Bibliography database tool pybliographer - tool for manipulating bibliographic databases bibtool-dev - A library providing functions to deal with BibTeX files. search-ccsb - BibTeX search tool search-citeseer - BibTeX search tool
то можно найти приличное количество таких программ.

Однако в плане удобства использования они сильно проигрывают JabRef, о которой и пойдёт речь дальше. Эта программа написана на Java, бесплатна и лицензирована под GPL - однако из-за того, что Java-машина в основную ветку дистрибутива Debian не входит (по лицензионным причинам), JabRef в Дебиане нет. Однако для неё есть дебиановский пакет, который можно скачать с сайта разработчиков, а пакет с Java-машиной - из non-free ветки дистрибутива Debian.

Ставим!
Итак, нам нужно скачать из Интернета пакеты j2re*.deb (у меня, например, jpre1.4_1.4.2.03-1_i386.deb), jabref*_all.deb (у меня установлен jabref_2.0.1-1_all.deb) и взять первый DVD-диск, на котором есть пакет java-common, входящий в стандартную поставку Дебиана.

Сначала ставим java-common из дистрибутива:
#apt-get install java-common
Далее ставим отдельно пакет с Java-машиной (если у вас более свежая версия - поправьте имя пакета):
#dpkg -i jpre1.4_1.4.2.03-1_i386.deb
Конфигуратор этого пакета может задать вопросы - типа согласны ли мы с лицензией (выбирать не приходится), и прочее. Отвечаем утвердительно - согласны с лицензией SUN и принимаем все остальные вопросы. Теперь ставим собственно JabRef - так же отдельно пакет (если у вас более свежая версия - поправьте имя пакета):
#dpkg -i jabref_2.0.1-1_all.deb
Всё - теперь добавляем JabRef в меню своего любимого оконного менеджера или графической среды и запускаем:
jabref
Так как программа на джаве, запускается она не быстро - это нормально. Интерфейс у неё простой и понятный.

Осталось только вбить литературные источники в этой программе в новую базу, сохранить, поставить во всех документах упоминание о том, что мы теперь используем BiBTex:
\bibliography{путь/к/файлу/библиографии}
и работать, как всегда - ставить ссылки на литературу, а уж BiBTeX сам разберётся, как её указать. И в конце вашего LaTeXовского файла всегда будет аккуратный список литературы по всем правилам хорошего тона.


Несколько советов

Во-первых, не забываем про архивирование данных - и особенно библиографической базы данных. Это теперь наше всё. Её можно экспортировать в HTML или просто скопировать куда-нибудь в другое место.

Во-вторых, разного рода издательства и их электронные ресурсы, такие как SpringerLink и Elsavier предоставляют Citations для опубликованных у них работ. Не проходите мимо них и собирайте эти замечательные файлы (они обычно в формате RIS, но могут быть и в других форматах). Скачав и импортировав в JabRef в свою базу такой файл, вы получите уже набранную информацию о статье или книге - вам только остаётся подобрать для неё подходящий ключ, на который будете потом ссылаться. И всё.

Для любопытных
Физически теперь ваши ссылки будут одним файлом с расширением bib, который, если его открыть текстовым редактором, будет похож на:
This file was created with JabRef 2.0.1.
Encoding: KOI8-R

@ARTICLE{catheydowskinewparadigm,
author = {W.T. Cathey and E.R. Dowski},
title = {New paradigm for imaging systems},
journal = {Appl. Opt.},
year = {2002},
volume = {41},
pages = {6080-6092},
owner = {penta4},
timestamp = {2006.05.12},
}

Это и есть ваша база данных библиографии. Её, как сказано выше, можно набивать чем угодно - программами или руками, а так же привлечь к этому делу скрипты. Так же можно обмениваться ими с коллегами по работе. В общем, полная свобода действий.


Как переименовать "Литература" (rename References in LaTeX)?
Если необходимо оформить список литературы для диплома, чтобы само название было СПИСОК ЛИТЕРАТУРЫ по центру (например). В зависимости от того, чем вы там диплом формляете (может, мудрёные пакеты какие), сделать можно вот так:
\begin{document}
\renewcommand\refname{\centering СПИСОК ЛИТЕРАТУРЫ}

Это если для стиля article. Если для report или book, тогда:
\renewcommand\bibname{СПИСОК ЛИТЕРАТУРЫ}
Почерпнул мудрости здесь.
Читать далее

Использование пакетов расширения LaTeX: LaTeX usepackage


5 коммент.
Задача: в ЛаТеХ нужно применять специфические, отличные от умолчальных, настройки (поля, списки и таблицы, библиографические ссылки и прочее).
Решение: для этого используются пакеты расширений, подключаемые в "шапке" ЛаТеховского документа.

Вот пример такой шапки с описанием действия пакетов. Шапка написана с сильным физико-математическим уклоном: для вёрстки статей и отчётов с обильным использованием формул, рисунков, таблиц и ссылок на литературу.

\documentclass[a4paper,12pt]{article}
\usepackage[T2A]{fontenc} %поддержка кириллицы в ЛаТеХ
\addtolength{\hoffset}{-1.7mm} % горизонтальное смещение всего текста как целого
\usepackage[koi8-r]{inputenc} %По умолчанию кодировка KOI8 для *nix-систем
и cp1251 для винды
\usepackage[english,russian]{babel} %определение языков в документе
\usepackage{amssymb,amsmath,amsfonts,latexsym,mathtext} %расширенные наборы
математических символов
\usepackage{cite} %"умные" библиографические ссылки
(сортировка и сжатие)
\usepackage{indentfirst} %делать отступ в начале параграфа
\usepackage{enumerate} %создание и автоматическая нумерация списков
\usepackage{tabularx} %продвинутые таблицы
% \usepackage{showkeys} %раскомментируйте, чтобы в документе были видны
ссылки на литературу, рисунки и таблицы
\usepackage[labelsep=period]{caption} %заменить умолчальное разделение ':' на '.'
в подписях к рисункам и таблицам
\usepackage[onehalfspacing]{setspace} %"умное" расстояние между строк - установить
1.5 интервала от нормального, эквивалентно
\renewcommand{\baselinestretch}{1.24}
\usepackage[dvips]{graphicx} %разрешить включение PostScript-графики
\graphicspath{{edgeimages/}} %относительный путь к каталогу с рисунками,
это может быть мягкая ссылка

\usepackage{geometry} %способ ручной установки полей
\geometry{top=2cm} %поле сверху
\geometry{bottom=2.5cm} %поле снизу
\geometry{left=2.5cm} %поле справа
\geometry{right=2cm} %поле слева

\makeatletter
\bibliographystyle
{unsrt} %Стиль библиографических ссылок БибТеХа - нумеровать
в порядке упоминания в тексте
%Заменяем библиографию с квадратных скобок на точку в списке литературы
\renewcommand{\@biblabel}[1]{#1.}
\makeatother

% Меняем везде перечисления на цифра.цифра
\renewcommand{\theenumi}{\arabic{enumi}}
\renewcommand{\labelenumi}{\arabic{enumi}}
\renewcommand{\theenumii}{\arabic{enumii}}
\renewcommand{\labelenumii}{\arabic{enumi}.\arabic{enumii}.}
\renewcommand{\theenumiii}{\arabic{enumiii}}
\renewcommand{\labelenumiii}{\arabic{enumi}.\arabic{enumii}.\arabic{enumiii}.}

\righthyphenmin=2 % Минимальное число символов при переносе - 2.
Читать далее

Работа с огромными растровыми изображениями в Linux: графический редактор nip2


3 коммент.
Задача: имеется большое растровое изображение, которое требуется обработать и улучшить, желательно видя результат и имея возможность изменив что-то одно, быстро пересчитать результат.
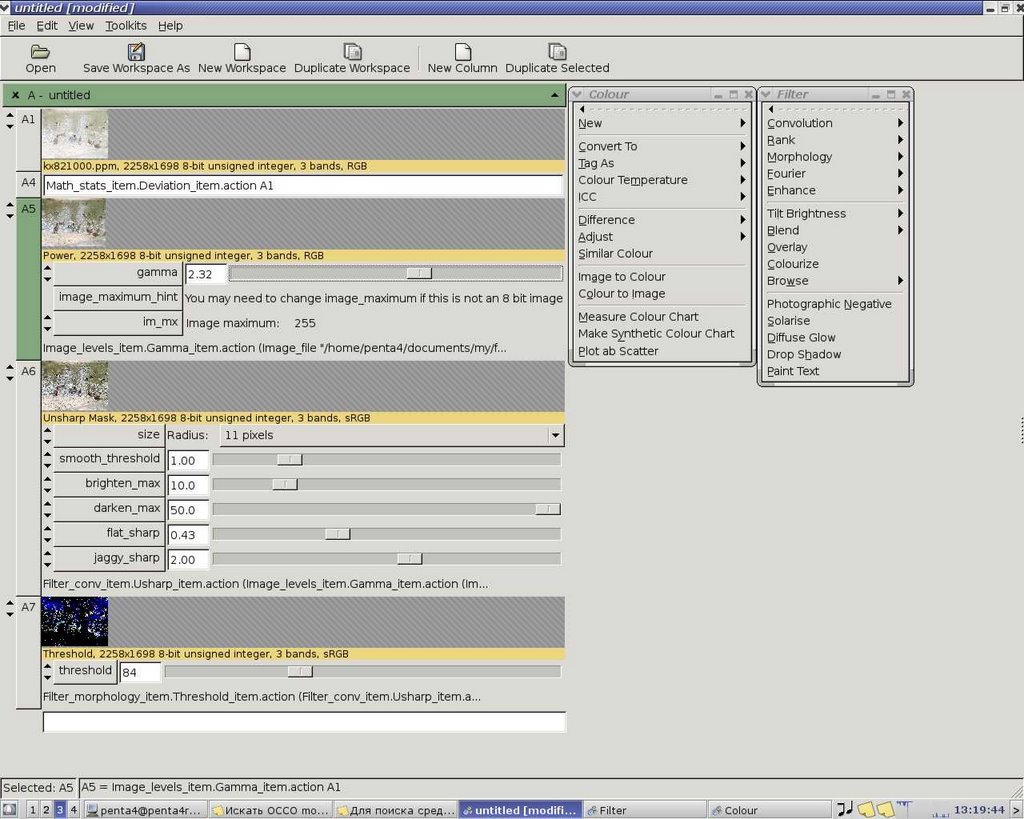
Решение: нам поможет уникальная программа для обработки музейных изображений - nip2, которая есть в составе Debian.

Подход nip2: изображения в виде таблиц
Неожиданный и очень продуктивный подход реализован в этой замечательной программе: каждое изображение помещается в ячейку таблицы. Его можно просмотреть, и оно будет воспроизводиться постепенно, так же ячейками. Это сильно экономит время и оперативную память. Когда вы применяете какой-либо фильтр обработки изображения, вы указываете ячейку, к которой это применяется. Таким образом, возможен оперативный пересчёт результатов при изменении параметров фильтров.

Каждое действие фильтра обработки приводит к тому, что результат помещается в следующую ячейку, куда помещаются и параметры фильтров обработки. Таким образом, если вы, например, изменили параметры гамма-коррекции изображения, все последующие фильтры, которые применены к изображению, быстро пересчитают окончательные и промежуточные результаты. Это лучше увидеть на скриншоте.
Так что nip2 э
то не графический редактор в привычном понимании, а мощный инструмент для всестороннего и интерактивного анализа растрового изображения даже очень большого размера.
Программа (по крайней мере версия 7) знает основные графические форматы, и, хотя их не так много, но работа с ними реализована очень хорошо.


Помимо служебных форматов, программа знает TIFF, PPM, PNG и JPEG. Немного, но этого хватает для нормальной работы с графикой.

Что есть и чего нет в nip2
Так как программа изначально заточена под работу с плоской графикой, нет функций работы со слоями - это не её профиль. Зато есть много очень продвинутых техник обработки изображений, реализованных в виде быстрых алгоритмов (следует отметить, что обработка изображений проходит намного быстрее, чем в аналогичных растровых графических редакторах, например, в GiMP).

Что есть:

- оперативный пересчёт конечного и промежуточных результатов при изменении параметров любого фильтра;
- работа с 8, 16 и 32 битными изображениями;
- реализованы продвинутые техники работы с изображениями (морфологический анализ, фурье-фильтрация, методы арифметической свертки, статистические техники шумоподавления и прочее);
- реализована работа с цветокоррекцией и цветовыми профилями;
- алгоритмы работают очень быстро, экономное расходование ресурсов;
- выдающиеся способности по обработки изображений большого объёма.

Чего нет:
- нет работы со слоями;
- нет возможности воспользоваться инструментами рисования (только обработка изображения фильтрами);

Из особенностей следует отметить необычный (но довольно понятный) интерфейс и не всегда логичное расположение фильтров в меню. Однако менюшки можно открепить, и самые нужные фильтры и инструменты будут под рукой.


Зачем нужен nip2
На самом деле, как говорится здесь, nip2 - это лишь графический пользовательский интерфейс на Gtk2 к библиотеке VIPS. Эта библиотека на С спроектирована для обработки очень больших изображений, главным образом, для исследований картин в музеях. Оцифрованные изображения произведений искусства - это огромные файлы, и обработка их в обычных графических редакторах просто немыслима. Кроме того, многие цифровые фильтры в графических редакторах применяют медленные алгоритмы обработки, так как их проще реализовать и не возникает специфических проблем.
У nip2 много преимуществ, помимо работы с очень большими изображениями, так что надеюсь, что программа будет полезна и вам.

Ссылки
Замечательная статья (а тут её английский источник)по библиотекам обработки изображений в Линукс - там говорится и о VIPS, на которой основан nip2.
Читать далее

Текстовые процессоры: Глупые и Неэффективные


36 коммент.
Предисловие
Это перевод замечательной статьи о том, что в ряде случаев применение визуальных текстовых процессоров типа Ворда и ОпенОфиса не только не оправдано, но и чрезвычайно неэффективно. Она показывает, хотя и несколько эмоционально, существенные различия между визуальным и логическим подходом к созданию документов. В статье приводятся убедительные примеры, иллюстрирующие во многих случаях преимущество логического метода как наиболее эффективного способа создания и набора действительно хорошо выглядящих документов. Все примеры подразумевают LaTeX, как наиболее совершенную систему компьютерного типографского набора.


Текстовые процессоры:
Глупые и Неэффективные

Аллин Коттрелл


Содержание


1 Утверждение

Текстовый процессор - глупый и чрезвычайно неэффективный инструмент подготовки текста для обмена информацией с окружающими. Это утверждение мне предстоит защищать ниже. Оно, вероятно, удивит вас своей эксцентричностью при первом прочтении. Если я выступаю против текстовых процессоров, что я предложу: писать от руки или использовать пишущие машинки? Нет. Можно найти аргументы в защиту этих моделей подготовки текста, но я понимаю, что большинство читателей этой заметки, как и я, выполняют львиную долю своей писательской работы на компьютере. Моё утверждение заключается в том, что есть намного лучшие способы подготовки текста, используя компьютер, чем текстовые процессоры.

Формулировка моего утверждения умышленно провокационная, но я внесу ясность: когда я говорю, что текстовые процессоры глупые, я не говорю, что вы, если используете текстовый процессор, тоже глупые. Я критикую технологию, которая усердно продвигается крупными производителями программного обеспечения, и которая стала стандартном де-факто. Вы скорее всего не подозреваете о существовании альтернатив. Альтернативные решения не продвигаются крупными производителями, по известной причине: как мы увидим, они свободно доступны.

Давайте начнём с конца. Текст, который предназначен для обмена идеями и информацией с окружающими, распространяется двумя главными путями:

  1. Как ``твёрдая копия'', в виде традиционных отпечатанных документов.
  2. В цифровом виде: электронная почта, веб-страницы, в формате, воспроизводимом на экране.

Здесь есть некоторые совпадения. Например, документ, предназначенный для печати, может быть распространён в цифровой форме в предположении, что у получателя есть возможность распечатать его. Но давайте рассмотрим эти два способа распространения по очереди.

2 Печатные документы

Вы хотите напечатать документ на клавиатуре, и ожидаете, что он красиво напечатается на вашем принтере. Естественно, вы не хотите, чтобы это произошло сразу (чтобы печатаемый вами текст появлялся на принтере в процессе написания). Вы хотите напечатать документ сначала и затем ``сохранить'' его в цифровой форме на каком-либо носителе. Вы хотите иметь возможность вернуться к документу и редактировать его в будущем, а так же отправить его на печать при желании. Верно ли, что текстовый процессор, такой, как захвативший большую долю рынка Майкрософт Ворд, ``естественный'' способ сделать всё это? Ну, это один способ, но не лучший. Почему?

2.1 Создание против Набора

Подготовка печатного текста при использовании текстового процессора обязательно вынуждает вас соединять две задачи, концептуально различные. Этими двумя задачами являются:

  1. Создание непосредственно текста. Под этим я понимаю непосредственный выбор слов для выражения мыслей, и логическое структурирование текста. Это включает такие вещи, как разбиение текста на параграфы, разделы и главы, выбор места появления главного материала в сносках или в основном тексте, выделение значимых частей текста, представление некоторых частей текста в качестве цитат вместо авторских слов, и так далее.
  2. Типографский набор документа. Имеется в виду выбор гарнитуры шрифта, которой будет отпечатан текст, и способ визуального представления структурных элементов. Должны ли заголовки разделов быть полужирными или написанные капителью? Должны ли они быть выровнены по левому краю или центрированы? Должен текст быть выровнен по ширине или нет? Должны ли заметки появляться вверху страницы или внизу? Должен ли текст идти одной колонкой или двумя? И так далее.

Автор текста должен, по крайней мере в первом приближении, быть полностью сосредоточен на первой из перечисленных задач. Это главная задача автора. Адам Смит, как известно, выявил огромные преимущества, вытекающие из разделения труда. Создание и логическое структурирование текста является решающим вкладом автора в производство печатного текста. Типографский набор - дело наборщиков. Это разделение труда было выполнено, разумеется, в традиционном производстве книг и статей в докомпьютерную эпоху. Автор писал и сообщал издателю логическую структуру текста с помощью различных пометок. Наборщик переводил авторский текст в печатный документ, преобразуя логическую разметку автора в конкретный типографское исполнение. Нужно только представить себе, скажем, Джейн Остин (Jane Austen) озадаченную, в каком шрифте набрать заголовок главы ``Гордость и Предубеждение'', чтобы увидеть, насколько нелепа эта фантазия. Джейн Остин - великая писательница; она не была наборщицей.

Вы можете подумать, что это не относится к делу. Произведения Джейн Остин были издаваемы; профессиональные наборщики были заинтересованы в разметке этого текста и его печати. Вы и я не столь удачливы; если мы хотим печатную статью, мы вынуждены делать это сами (и, кроме того, мы хотим сделать это намного быстрее, нежели при помощи обычных пишущих машинок). Мы чувствуем, что будем делать это сами (на собственных компьютерах), но в нашем распоряжении много помощников. В частности, у нас есть программы создания документов профессионального качества. Эта программа (или набор программ) способна сделать это за нас, бесплатно и за несколько секунд или долей секунд; сделать работу, которую обычные наборщики выполняли для Шекспира, Джейн Остин, сэра Вальтера Скотта и остальных. Мы просто воспользуемся программой с подходящим размеченным текстом, как делали традиционно авторы.

Я полагаю, следовательно, что должны быть два различных момента в производстве печатного текста с использованием компьютера. Первый печатает собственно текст и создаёт правильную логическую структуру, отмечая эту структуру простыми пометками. Это достигается при использовании текстовых редакторов, программ, которые не должны быть смешаны с визуальными текстовыми процессорами (ниже я объясню эту разницу более подробно). Дальше текст передаётся программе типографского набора, которая быстро вернёт восхитительно набранную копию.

2.2 Зло имени ``Что видишь, то и получаешь''

Эти две работы превращаются в одну при помощи современных визуальных1 ``что видишь, то и получаешь'' текстовых процессоров. Вы печатаете свой текст, в то же время, как видите набираемый текст на экране компьютера и его конкретное типографское представление, которое близко соответствует тому, что вы распечатаете на принтере. В результате, текст постоянно оформляется по ходу его создания. На первый взгляд это может показаться огромным удобством; при ближайшем рассмотрении это настоящее бедствие. Есть три причины этого:

  1. Автор отрывается от своего дела - создания текста - для выбора типографских приёмов, в которых он может совершенно не разбираться (``маяться со шрифтами и полями'' в то время как он должен сконцентрироваться на тексте).
  2. Алгоритм типографского набора, применённый в визуальном процессоре, жертвует качеством во имя скорости, требуемой для оформления и изменения вводимого пользователем текста в реальном времени. Окончательный результат сильно ниже по качеству того, который получается в настоящей программе типографского набора.
  3. Пользователь текстового процессора испытывает большой соблазн потерять видение структуры текста и совместить это с поверхностными типографскими элементами.

Первые два пункта должны быть очевидными. Позвольте мне раскрыть третий (его важность зависит от типа рассматриваемого документа).

2.3 Структура документа

Рассмотрим для примера заголовок раздела. Как только логическая структура текста становится главной целью, требуется, чтобы важные части текста помечались бы, как заголовки разделов. Можно, например, написать \section{Text of heading}. Как заголовки разделов будут воспроизведены типографски в печатном документе - отдельный вопрос. Когда вы используете текстовый процессор, то, что вы видите есть (всё!) что вы получите. Вас вынуждают решать специфические типографские вопросы об отображении заголовка.

Положим, вы решили, что хотите заголовки сделать полужирными, и немного больше остального текста. Как вы собираетесь достичь этого? Есть более одного способа это сделать, но для большинства людей наиболее очевидным и интуитивным путём (дающимся в визуальной среде) является набор текста в заголовок, выделения его, нажатия на значок ``сделать полужирным'', открывания ниспадающего меню размеров шрифта и выбора большего размера. Заголовок теперь полужирный и большой.

Отлично! Но что говорит о том, что это заголовок? В документе ничто не идентифицирует этот маленький кусочек текста как заголовок раздела. Предположим, что через некоторое время вы захотите, чтобы заголовки были написаны капителью, или нумеровались римскими цифрами, или были отцентрированы, или что-нибудь ещё. Вы бы хотели сказать ``пожалуйста, сделайте это и это для изменения всех заголовков раздела''. Но если вы применили форматирование так, как описано выше, вы должны будете пройтись по всему документу и изменить каждый заголовок вручную.

Теперь есть способ определения структурного положения участков текста, например, в Майкрософт Ворде. Вы можете, если вы аккуратны, достичь эффектов типа изменения представления всех заголовков разделов одной командой. Но лишь немногие пользователи Ворда применяют это постоянно, и это не удивительно: визуальный подход не поощряет заботу о структуре. Вы можете легко - всё слишком легко - создать видимость структуры низкоуровневыми командами. Когда пишете текст используя текстовый редактор, с другой стороны, необходимость разметки структуры возникает сразу же.

2.4 Текстовые редакторы

Хорошо, теперь, вероятно, пора объяснить, что такое текстовый редактор и чем он отличается от текстового процессора. Современный текстовый редактор выглядит очень похожим на визуальный текстовый процессор. Он имеет обычные механизмы ниспадающих меню и/или иконок для функций открытия и сохранения файлов, поиска и замены, проверки орфографии, и так далее. Но он не имеет типографской функциональности. Текст, который вы набираете, отображается на экране в простом виде, но без претензии на отображение окончательного печатного документа.

Когда вы сохраняете документ, он сохраняется в форме простого о текста, который в США подразумевается как ``ASCII'' (the American Standard Code for Information Interchange, Американский Стандартный Код для Обмена Информации)2. Кодировка простого текста состоит из 128 символов (иногда это называют ``7-ми битным'' набором символов, так как он требует 7 бинарных знаков для кодирования; 2 в седьмой степени составляют 128). Он включает числа от 0 до 9, латинский алфавит в верхнем и нижнем регистре, стандартные символы пунктуации и набор специальных символов. Сообщение на простом тексте будет ``понято'' любым компьютером в мире. Если вы отправите такое сообщение, вы можете быть уверенным, что получатель увидит буквально то, что вы набрали.

С другой стороны, когда вы сохраняете файл из визуального текстового процессора, файл содержит различные ``управляющие'' символы, выходящие за диапазон кодировки простого текста. Эти символы представляют форматирование, которое вы применили (например, полужирное или наклонное) и различные виды внутренних ``служебных'' символов, относящихся к внутреннему устройству визуального текстового процессора. Они не являются универсальными. Чтобы они имели смысл, вам необходима копия текстового процессора, которым создавался текст (или некоторый подходящий конвертор). Если вы откроете файл визуального текстового процессора в текстовом редакторе, вы увидите (кроме текста, или его битов), много ``забавно выглядящей чепухи'': это бинарный форматирующий код.

Так как текстовые редакторы не вставляют никакого бинарного форматирующего кода, если вы хотите показать форматирование, например наклонный шрифт, вы должны сделать это с помощью меток разметки. А именно, вы пишете примечания (используя только простой текст), которые скажут системе типографского набора сделать указанный текст наклонным. Например, для системы набора LaTeX (о которой пойдёт речь ниже) вы должны написать \textit{текст, который вы хотите сделать наклонным}. В действительности, если вы используете текстовый редактор, созданный для взаимодействия с LaTeX, вам не придётся набирать это самостоятельно. Вы можете нажать комбинацию клавиш, выбрать из меню или нажать на значок, и соответствующее примечание будет вставлено за вас; механизм набора текста в текстовом редакторе, предназначенном для LaTeX, не сильно отличается от набора в современном визуальном текстовом процессоре.

2.5 Сила простого текста

Метод создания текста в простом тексте с использованием текстового редактора и компьютерной системы типографского набора имеет несколько ``побочных'' преимуществ:

  1. Портируемость: как указано выше, любой человек, используя любую компьютерную платформу, в состоянии прочесть ваш размеченный текст, даже сли он не собирается просматривать или распечатывать набранную версию. С другой стороны, файл вашего навороченного визуального текстового процессора Шик-Блеск 9.0 может быть полностью не воспроизводим для получателя, не имеющего такого же визуального процессора той же версии, что и у вас - если он или она не настолько продвинутые в компьютерах, что способны вытащить простой текст из этого бинарного ``мусора''. И это заставляет тратить дополнительно время и вас, и получателя вашего документа. Вы так же можете встретить проблемы с чтением файла текстового процессора Шик-Блеск 8.0 программой новой версии 9.0, или наоборот, но вы никогда не будете иметь таких проблем с чтением старого доброго о текста.
  2. Компактность: файл текста представляет ваши записанные мысли, а не кучу бинарного ``хлама'' визуального процессора. Для небольших документов файлы визуального текстового процессора могут быть в 10 раз больше соответствующего о текста, содержащего ту же информацию.
  3. Безопасность: метод ``текстовый редактор в качестве системы типографского набора'' практически гарантирует отсутствие проблем с повреждением ваших документов (только если ваш винчестер не выйдет из строя или не произойдут прочие форс-мажоры). Ваш исходный текст всегда будет с вами, даже если система компьютерного набора выйдет из строя по каким-либо причинам. Если вы регулярно используете визуальные текстовые редакторы и не имеете таких проблем с повреждением файлов, вы чрезвычайно везучий человек!

(Для дальнейшего чтения: страница Сэма Стейнголда ``Нет проприетарным форматам данных'')

2.6 Системы компьютерного типографского набора

К этому времени, я так чувствую, вы уже больше разбираетесь в типографской части стратегии, которую я отстаиваю. Я не хочу здесь пускаться в технические подробности, но постараюсь сказать достаточно для того, чтобы вы поняли, о чём я говорю.

Основная программа, которую я подразумеваю, называется ТеХ и она была написана Дональдом Кнутом из Стэнфордского университета. ТеХ свободно доступен (можно скачать со многих ресурсов в Интернете), для любой компьютерной платформы (вы можете, если захотите, купить диск с полным набором файлов ТеХа по очень умеренной цене). Кнут начал работу над ТеХом в 1977 году; в 1990 он заявил, что больше не собирается разрабатывать программу - не потому, что потерял к ней интерес, а потому, что к этому времени она стала почти совершенна. Она свободна от ошибок настолько, насколько любая компьютерная программа может быть, и она превосходно выполняет типографский набор практически любого материала, от простого текста до высшей математики.

Я ссылался выше на ЛаТеХ. Если ТеХ - базовый типографский движок, ЛаТеХ - огромный набор макрокоманд, изначально разработанных Лэсли Лэмпортом в 80-ых годах 20 века и ныне поддерживаемых интернациональной группой экспертов. Эти макрокоманды делают жизнь гораздо проще для среднего пользователя системы. ЛаТеХ до сих пор находится в активной разработке, так как новые возможности и пакеты надстраиваются над базовым движком. Различные ``дополнения'' для ТеХа так же разрабатываются, позволяющие, например, создавать PDF (``Портативный Формат Документов'' компании Адоб) файлы напрямую из исходного размеченного текста (я говорю ``в разработке'', но имею в виду, что они постоянно улучшаются; программы уже очень стабильны и обладают всеми возможностями).

Как упоминалось выше, вы обозначаете желаемую структуру и форматирование вашего документа для ЛаТеХа в виде набора примечаний. Есть много книг и пособий в Интернет, которые рассказывают о подробностях этих примечаний, и я не буду здесь об этом писать. Наиболее употребительные команды просты и легко запоминаются, кроме того, ЛаТеХ-ориентированный текстовый редактор (коих множество) часто упрощает вставку этих команд.

Одна из притягательных возможностей ЛаТеХ - возможность менять частично или полностью типографское представление вашего текста лишь несколькими командами. Общее представление текста управляется:

  1. изменением ``класса документа'' (например, отчёт, письмо, статья, книга);
  2. применением ``пакета'' или файла стиля, которые вы хотите загрузить.

Вы можете, например, полностью изменить гарнитуру шрифта (для текста, заголовков разделов, сносок и всего прочего) и/или размеров используемых шрифтов изменением лишь одного или двух параметров в ``преамбуле'' вашего исходного размеченного текста. Точно также вы можете оформить всё, что угодно, в формат двух колонок, или повернуть страницы с портретной ориентацией на ландшафтную. Вероятно, есть такая возможность и у визуальных текстовых процессоров, но обычно это менее удобно и вы гораздо более вероятно приведёте всё в беспорядок и перепутаете всё из-за неудобства форматирования.

Типографский набор вы можете сделать столь подробным, насколько вы сами хотите этого. Вы можете выбрать полностью автоматический режим: просто определите класс документа и предоставьте всю остальную работу выполнить по умолчанию макрокомандам. В большинстве случаев это приводит к хорошим результатам, набор становится существенно более высокого качества, чем в любом визуальном текстовом процессоре (естественно, такие вещи как нумерация глав, заголовков и сносок, перекрёстные ссылки и всё остальное делает автоматика). Или вы можете более глубоко вмешиваться в процесс набора, загружая различные пакеты (или даже создавая свои собственные) для управления различными аспектами типографского набора. Если вы чувствуете к этому склонность, вы можете создавать действительно восхитительные и уникальные документы.

2.7 Соединяем всё вместе

Позвольте мне кратко рассказать о том, как всё это работает. Если у вас есть правильно установленный ТеХ, это выглядит примерно так: вы набираете текст в ТеХ-редакторе. Вы можете набирать требуемые метки оформления напрямую или вставлять их через выбор в меню или нажатия на кнопки. Когда вы захотите посмотреть на печатную версию, вы выбираете в меню или нажимаете на кнопку в редакторе вызов подсистемы набора. Другая кнопка или пункт меню откроют просмотрщик, где вы увидите текст таким, каким он выйдет из принтера. Вот именно это и есть истинно визуальный просмотр, показывающий чрезвычайно точно текст, который будет выведен на принтер. Вы можете приближать его или отдалять, просматривать страницы и так далее. Вы посылаете этот текст на принтер нажатием на другую кнопку или пункт меню, или возвращаетесь к редактированию.

Через некоторое время вы захотите просмотреть обновлённый файл. Нажмите на кнопку вызова подсистемы набора снова. На этот раз вам не придётся вызывать просмотрщик - если вы оставили его запущенным на фоне, он автоматически отобразит обновлённую набранную версию. Когда вы закончите с редактированием, вы можете удалить печатную версию файла для освобождения места на диске. Вам нужно только сохранить исходный файл размеченного текста; печатная версия может быть легко получена в любое время, как только потребуется.

3 Цифровое распространение

Предыдущий раздел был больше посвящён созданию хорошо выглядящего документа для вывода на принтер. Возникают дополнительные вопросы, когда вы готовите документ для цифровой передачи (электронная почта, веб-страницы и так далее).

Возьмём для начала электронную почту. Обычно если человек хочет послать короткое, ``по случаю'', письмо, он печатает это письмо непосредственно в программе почтового клиента, независимо от того, является эта программа консольной (вроде Pine) или с графическим интерфейсом (например, Mozilla Thunderbird или Sylpheed)3. В этом случае письмо выходит в форме о текста (или, возможно, HTML, то есть языка разметки гипертекстовых документов, языка веб-страниц, которые сами по себе состоят из текста). Но что, если мы хотим послать более длинный текст, который подготовлен независимо от почтовой программы?

Для этих целей наиболее популярным является вложение в письмо документа, созданного в визуальном текстовом процессоре. Как альтернативная стратегия работает в этом случае?

Итак, мы провели различие между двумя ситуациями: является ли текст относительно короткий и несложный (записка, письмо, время собрания, список дел, расписание встреч) или более сложный (научная статья - вероятнее всего с множеством математических формул, отчёт с иллюстрациями, монография)? Подход `` текст плюс компьютерный набор'' предлагает разные решения для этих двух случаев.

3.1 Простой документ

В случае с простым документом мы должны спросить: вам действительно нужен компьютерный набор, информация о шрифте и всё прочее? Не является ли более продуктивным, более эффективным и экономичным сообщением просто напечатать простой текст, с минимальными элементами форматирования, которые позволяет простой текст? Это позволяет и экономить объём передаваемой информации (не забывайте, что файлы визуальных текстовых процессоров могут быть существенно больше простого текста, содержащего ту же фактическую информацию) и гарантирует, что никто не будет лишён возможностей прочесть сообщение из-за того, что они не могут запустить визуальный текстовый процессор Шик-Блеск 9.0. Вы можете прикрепить простой текст, созданный в текстовом редакторе, точно так же, как если бы прикрепили файл визуального текстового процессора, или просто можете вставить его из буфера обмена в тело сообщения (так как он содержит только простой текста). Так как исходные файлы ТеХа не содержат ничего более простого текста, вставленный размеченный текст содержит простые и очевидные метки форматирования, которые легко понять.

3.2 Сложный документ

Более длинные и сложные документы с тем же успехом могут быть прочитаны в форматированном виде. Математические символы трудно выражать в простом тексте, и, конечно, сложные диаграммы и изображения явно выходят за рамки возможностей простого текста. Как насчёт применения ТеХ в этом смысле? Я показал, что файлы визуального текстового процессора могут вызвать проблемы, поскольку у вашего получателя может не найтись визуального текстового процессора Шик-Блеск 9.0, который есть у вас. Но нельзя ли совместить их воедино? Даже если вы достаточно разбираетесь в ТеХе, чтобы попробовать его, как много ваших получателей имеют установленный ТеХ? Это резонный вопрос, но на него можно ответить. Если вы хотите, чтобы ваш получатель мог увидеть оформленную версию вашего файла без необходимости устанавливать ТеХ, вы можете:

  1. Конвертировать исходные тексты ТеХа в HTML. Имеются хорошие программы для этих целей (HTML и ТеХ на самом деле имеют тесные родственные узы, так как они оба позволяют логически размечать текст, так что их взаимная конвертация может быть выполнена с высокой точностью4. Тогда ваш получатель сможет прочесть оформленный текст любым броузером.
  2. Ваш получатель имеет доступ к Postscript-принтеру? В академической или деловой среде это очень частое явление. В этом случае вы можете послать полностью оформленную версию вашего документа в виде postscript-файла, который может быть просто отправлен на принтер. И/или его можно просмотреть на экране при установленной программе типа ghostview (свободна для загрузки из Интернета).
  3. Ваш получатель имеет установленный просмотрщик PDF-файлов вроде Adobe Acroread? (Опять-таки, он свободен для загрузки) Если так, вы можете послать полностью оформленную PDF-версию вашего документа.

При рассмотрении способов передачи текста по электронной почте, мы уже упоминали подготовку текста для веб-страниц. Вы можете написать документ в HTML-формате напрямую. Если вы не хотите этого, вы можете создавать HTML-документы при помощи подходящих графических средств, типа NVU5. Конечно, вы так же можете получить HTML-файл из Ворда (обычно ужасный HTML, полный чужеродных тэгов, что делает его трудным для редактирования в любых других приложениях). Если вы создаёте документы в ТеХ, то очень просто конвертировать его в чистый, стандартизированный HTML.

4 Оговорка

Я попытался рассказать об альтернативном методе ``текст плюс система компьютерного набора'' в ущерб методу визуальных текстовых редакторов. Я понимаю, однако, что есть некоторые виды документов, для которых визуальные процессоры являются на самом деле лучшими инструментами. Полагаю, что это короткие, по случаю, документы, в которых дело оформления превыше содержимого: флаеры, постеры, пригласительные билеты на вечеринки и тому подобное. Вы можете сделать это и в ТеХ, но это будет не эффективно. Стандартных ЛаТеХовских классов (отчёт, статья и прочие) вам, очевидно, не хватит. И хотя ЛаТеХ очень лихо орудует различными вариантами шрифтов, которыми вы можете захотеть оформить текст, он не предназначен для смешивания и вкрапления весёленьких шрифтов, которыми вы захотите набрать несерьёзный документ. Логическая структура тут не главное: вы заинтересованы в возможностях ``чистого форматирования'' документа. Если вы хотите знать, оформляя эту строку шрифтом 36 кегля, не вытолкнет ли она последнюю строку на следующую страницу, чего вы не хотите? Тогда визуальные процессоры - ваш выбор.

Если большая часть вашей работы с текстом именно такого сорта, вы, скорее всего, уже давным-давно перестали читать эту статью. Если большая часть работы по подготовке текста связана с созданием относительно формальных документов, эта оговорка в данном случае не имеет значения.

5 Демагогия, демагогия

Наверное, не ускользнуло от вашего внимания то, что я до некоторой степени подготовился к этой теме. Да, это так. Дело в том, что это не предмет для академического спора между альтернативными методами подготовки текста. Чаша весов, в которых могущество и богатства основных производителей программного обеспечения, вся на одной стороне. Глупо, что мы рассматриваем ситуацию, в которой Микрософт Ворд уверенно стал, для большинства в мире, стандартном подготовки документов с использованием компьютеров. Но Ворд это стандарт, которому нечем больше похвалиться кроме того, что он является (или домогается того) быть стандартом.

Это очень похоже на ситуацию с раскладкой QWERTY. Вы знаете эту историю? Почему стандартное расположение клавиш на пишущей машинке (что распространилось и на компьютерные клавиатуры) имеет символы QWERTYUIOP на верхнем ряду клавиатуры? Оно не было таковым изначально. Это было придумано для того, чтобы существенно снизить скорость печати. Проблема была в том, что компетентность машинисток тех лет быстро обогнала возможности первых механических пишущих машинок: быстрая печать могла привести к застреванию клавиш, когда нажатие происходило быстрее, чем клавиша возвращалась обратно, ударившись о ленту. Раскладка QWERTY расположила клавиши таким образом, чтобы невозможно было печатать быстро. Это откровенно безумное расположение для клавиш на клавиатурах, но теперь слишком поздно что-либо менять: QWERTY - стандарт, и все попытки рационализировать клавиатуры разбивались об эту реальность.

Точно так же, я заявляю, что Ворд не имеет права быть стандартном подготовки документов, так как он однозначно менее эффективен (для большинства применений), чем уже существующие альтернативы. Надеюсь, что ещё не поздно в этом случае, что есть ещё возможность сказать НЕТ Ворду. На самом деле, в случае с Вордом, он хуже QWERTY: это не настоящий стандарт, но скорее попытка навязать его. Микрософтский ``стандарт'' для бинарного представления документа это что-то вроде прихоти корпорации Микрософт. Квази-монополия Ворда это лишь довесок к квази-монополии Микрософт Виндовс (событие, о котором я не буду здесь говорить). И до тех пор, пока на них хорошенько не надавят конкуренты, Микрософт не имеет никакого интереса в установке любого долгосрочного стандарта бинарного представления форматирования. С другой стороны, у них есть веские основания вынуждать вас ``обновлять'' Ворд время от времени. О, святая Мария Гваделупская, Ворд версии N+0 не желает читать документ, присланный вашими коллегами, созданный в Ворде версии N+1? Ну, наверное лучше обновить его, правда? Даже если в версии N+1 не появилось никаких новых возможностей по сравнению с версией N6

6 Ссылки

Если вы дочитали до этого места, вы скорее всего заинтересованы в более подробной информации о хороших текстовых редакторах, системе компьютерного набора ТеХ и так далее.

Лучшим местом для начала изучения ТеХ и ему подобных, вероятно, это домашняя страница TUG (TUG - TeX Users Group - Группа пользователей ТеХ). Здесь размещены все ссылки, которые вам могут потребоваться; одна из главных ведёт на сайт CTAN (Исчерпывающая Архивная Сеть ТеХ), с которого вы можете скачать полную систему ТеХ для практически любой компьютерной платформы. Эта система включает в себя программу типографского набора, большую коллекцию макрокоманд, просмотрщик и программное обеспечение для создания печатных файлов.

Пакеты ТеХа (свободные для любого использования) не включают обычно текстовых редакторов, которые вам так же потребуются (только если вы у вас нет такого). Выбор тут велик, но мой любимый текстовый редактор для работы с файлами ТеХа - Emacs, поставляемый с пакетом AUC TeX7. Последний делает Emacs очень дружественным к ТеХ: он будет подсвечивать синтаксис ТеХа, так что вы быстро увидите любые ошибки в вашей разметке, а так же он предоставляет широкий выбор команд ТеХ в виде обычных меню.

Если вы заинтересовались, здесь находится снимок экрана работы с TeX в текстовом редакторе Emacs8 (PNG, 40678 bytes).

Примечание

... визуальных1
прим. перев.: Автор текста постоянно употребляет аббревиатуру WYSIWYG, которую затруднительно перевести адекватно на русский. Здесь и далее я буду заменять это слово на варианты слова ``визуальный'', в частности, WYSIWYG-wordprocessors на ``визуальные текстовые процессоры''.
... Информации)2
прим. перев.: И снова, всюду аббревиатура ASCII будет заменяться на ``плоский/простой текст'', тем более, что символы нашего алфавита тоже туда не входят.
... Sylpheed)3
прим. перев.: В оригинале было ``Netscape или Eudora'', но первый уже помер и я заменил его на потомка - Thunderbird, а второй заменил по религиозным соображениям (нет в Дебиане) на Sylpheed
... точностью4
Бинарное кодирование, используемое в визуальных текстовых процессорах, чрезвычайно разнообразная зверюга, так что взаимная конвертация между ТеХом и форматом визуального текстового процессора не так проста. В дополнении ко всему, так как ТеХ - превосходный наборный движок, в принципе невозможно конвертировать ТеХовский документ, например, в Ворд, без потери части информации о форматировании
... NVU5
прим. перев.: В оригинале - Netscape Communicator, но он, как поётся в песне, мёртв, а я - ещё нет. Заменён на NVU, для которого есть дебиановский пакет.
... N6
Это особенно ценно, на мой взгляд, для человека, использовавшего Ворд на протяжении нескольких лет до перехода на ТеХ, и кто остро интересуется типографским набором, никаких стоящих возможностей не было добавлено в Ворд для виндовс с версии 2.0 с примерно 1990 года
... TeX7
прим.перев.: мой выбор не совпадает с мнением автора - посмотрите на Kile, который входит в поставку почти любой nix-системы; может быть, он и вам понравится.
... Emacs8
прим.перев.: А если захотите посмотреть на Kile - вот ссылка.
Читать далее

Обработка изображений: конвертация из RAW-формата


9 коммент.
Задача: требуется конвертировать снимки в RAW формате в Linux.
Решение: в Debian GNU/Linux есть несколько утилит, способных нам помочь - их можно просто поставить и сразу с ними работать.

Зачем и кому оно надо?
Многие цифровые камеры позволяют сохранять данные в RAW-формате - данные прямо с матрицы фотоприёмника, повторяющие структуру массива фотосенсоров (RGRGRG..., GBGBGB...). Для того, чтобы изображение можно было редактировать, его необходимо конвертировать из RAW-формата, использовав информацию о балансе белого, контрастности и интерполировав чёрно-белые значения баеровской матрицы в цветные пиксели. Некоторые конверторы, способны выдавать именно чёрно-белый массив точек, без цветовой интерполяции.
RAW-конвертор выполняет следующие преобразования:
  • Интерполяция баеровского массива точек в цветное изображение: наиболее важная функция. Почти все фотосенсоры (за исключением матриц Foveon) используют баеровский примитив RGGB. В процессе интерполяции из этих пикселей восстанавливаются цвета итеративными методами, что обеспечивает минимальное количество артефактов;
  • Баланс белого: съёмка часто производится при различных источниках света, каждый из которых имеет свою цветовую температуру. Она указывается при конвертации из RAW-формата.

Какие средства есть в Дебиане?
Простой поиск в репозитории
# apt-cache search RAW | grep image
выдаёт немало интересного, среди чего выделяются:
dcraw - decode raw digital camera images
gimp-ufraw - Gimp importer for raw images
mrwtoppm - tool to convert Minolta DiMAGE 5/7/7i RAW images to PPM
mrwtoppm-gimp - GIMP-plugin to support Minolta DiMAGE 5/7/7i RAW images
Всего этого должно хватить, чтобы более или менее комфортно работать с RAW-форматом в Linux.

Ставим и смотрим
Замечание по ходу: я прекрасно знаю, что этими несколькими программами средства по работе с RAW в Линукс не исчерпываются, однако пока я расскажу о том, что есть под руками, а потом, если будет желание, время и возможности, и о других программах. А пока о том, что есть непосредственно в Дебиан, во всяком случае в Debian v3.1 Sarge.

1. gimp-ufraw

Итак, первой программой, которой я воспользовался для работы с RAW-файлами, была gimp-ufraw - плагин для GiMP, дающий возможность конвертировать RAW. После установки этого плагина и перезапуска GiMP в меню появилась строчка, свидетельствующая о поддержке "чистого" формата. При попытке открыть RAW-файл, полученный с камеры, появляется диалог конвертора:

Скажу прямо, для бесплатной программы очень и очень неплохо. Можно поменять экспокоррекцию, баланс белого, цветовую температуру. Далее имеются настройки для цветовых профилей - по умолчанию sRGB, но скачиваением и установкой плагинов можно добавить огня в эти настройки. Самое интересное - управление кривыми: можно выставить линейные кривые, гамма-кривые и логарифмические. Внизу имеется гистограмма и проценты пере- и недоэкспонированных пикселей. Что ж, для GiMPовского плагина это, наверное, пять с плюсом.
Кроме RAW-файла Casio QV4000 были так же успешно открыты файлы с камер Canon EOS300D и FujiFilm S2 Pro. Тут надо отметить один забавный момент: в навороченном Adobe Photoshop CS2 тоже есть RAW-конвертор, но помимо перегруженности его совершенно бесполезными ползунками (и отсутствием нужных), был удивлён, что он не смог открыть RAW с моей камеры Casio. Вот так проприетарный продукт! А такой простой камеры не знает... Так что ufraw в этом плане обгоняет в том числе и проприетарные конверторы.
В общем, gimp-ufraw очень понравился, и он стал основным инструментом по работе с RAW-форматом.

2. dcraw
Далее была опробована программа dcraw, которая конвертирует RAW-файлы в формат ppm и фотошоповский psd. Утилита консольная и очень мощная, с большим количеством параметров. Она, как и gimp-ufraw, без проблем разобралась с raw-файлом моей камеры Casio, и конвертировала его в 16-бит ppm:
$ dcraw -2 kx821000.raw
Это, согласно справке dcraw (вызов без параметров, помимо man dcraw), преобразует в 16-бит ppm мой указанный файл. Отлично, справилось и открылось GiMP.
Среди других интересных и полезных опций программы:
-a Use automatic white balance
-w Use camera white balance, if possible

-m Don't convert camera RGB to sRGB
-d Document Mode (no color, no interpolation)
-f Interpolate RGGB as four colors
-s Use secondary pixels (Fuji Super CCD SR only)
-2 Write 8-bit PPM with 0.45 gamma (default)
-3 Write 16-bit linear PSD (Adobe Photoshop)
-4 Write 16-bit linear PPM
я бы выделил -d, которая позволяет вытащить из файла просто баеровский массив точек, без конвертации в цвета. Почти то, что и упало на матрицу. Для художественной съёмки это в общем особенно не нужно, а для научной - очень пригодится: часто нужен именно массив точек, без интерполяции на цвета. Благодаря dcraw теперь это можно получить.

Заключение
Всё меньше и меньше областей превосходства проприетарных программ над бесплатными - и это не может не радовать. Вот и в обработке RAW-файлов пользователи открытых систем не обделены хорошими и мощными утилитами, такими, как gimp-ufraw и dcraw. Есть и другие программы, но о них в других постах.
Читать далее